


當前 AI 產業的發展核心,正經歷從重資本的「模型訓練(Training)」邁向商業化變現的「AI 推論(Inference)」階段。在這個轉折點上,硬體架構遇到一個棘手的瓶頸:GPU 算力雖然飆升,但將龐大的 AI 模型資料庫輸送給晶片的速度卻遠遠落後,這就是業界常說的「記憶體之牆(Memory Wall)」。
目前廣泛使用的解決方案是 HBM(高頻寬記憶體)。它的傳輸速度極快,但造價高昂且單一封裝的容量有限,難以應付未來千億參數等級的大型語言模型。若退而求其次,使用傳統的 SSD 固態硬碟,資料傳輸的延遲又會嚴重拖垮系統效能。為了解決這道難題,一項兼具大容量與高頻寬的新型技術——HBF(High Bandwidth Flash,高頻寬快閃記憶體)正式誕生,成為重塑 AI 基礎設施的關鍵佈局。
記憶體底層架構解析:DRAM 與 NAND Flash 的雙強分工
在深入探討 HBF 之前,我們不妨先透過下表,快速掌握 AI 運算架構中最核心的兩大「記憶體家族」,在物理體質與成本結構上有何根本差異:
| 資料來源:自行整理 | ||||
| DRAM 與 NAND Flash 核心特性與 AI 應用對照 | ||||
| 類型 | AI 應用 | 資料保存特性 | 存取速度與擴充性 | 建置成本 |
| DRAM | HBM | 揮發性 (斷電即遺失) | 速度快 / 擴充容量難 | 高 |
| NAND Flash | HBF、企業級 SSD | 非揮發性 (斷電不遺失) | 速度較慢 / 可擴展至 TB 級 | 低 |
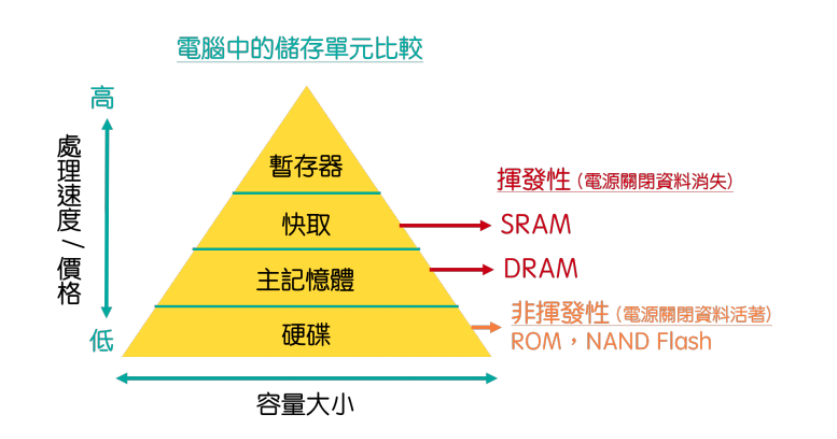 資料來源:寫點科普
- DRAM: 在 AI 運算架構中,它扮演著緊臨 GPU 的「高速快取工作區」。面對算力晶片每秒海量的平行運算需求,DRAM 能提供極低延遲與高頻寬的傳輸效能,確保運算核心在進行邏輯推演時,能即時存取最關鍵的動態數據,避免算力閒置。
- NAND Flash: 由於大型語言模型(LLM)的參數規模動輒千億起跳,若將龐大的靜態模型權重全數配置於高成本的 DRAM 中,將面臨嚴峻的成本與容量瓶頸。因此,NAND Flash 憑藉高儲存密度與低單位成本的物理優勢,成為系統中的「大容量儲存層」,專責以極高性價比來承載這些無需頻繁覆寫的海量靜態資料。
HBF 是什麼?專為 AI 推論打造的新世代儲存架構
HBF 的核心設計理念,在於重塑伺服器的記憶體階層。透過將高容量的 NAND Flash 部署至極度貼近 GPU 或 AI 加速晶片的位置,HBF 成功打破了傳統儲存設備在實體距離上的傳輸瓶頸。
為了解決 AI 推論階段對靜態資料讀取的嚴苛要求,HBF 在硬體設計與架構上具備以下三大關鍵特徵:
- 底層晶片選用 SLC NAND: 由 SK 海力士與閃迪(SanDisk)等大廠主導的 HBF 規格,捨棄了主流市場追求極限容量的 TLC(Triple-Level Cell,三層儲存單元) 或 QLC(Quad-Level Cell,四層儲存單元),轉而採用 SLC(Single-Level Cell,單層儲存單元)架構。由於每個記憶單元僅儲存 1 bit 的資料,SLC 具備業界最佳的寫入壽命、耐用度與存取速度,能完美契合 AI 推論時密集且海量的資料讀取負載。
- 導入 3D 封裝與 TSV 矽穿孔技術: HBF 之所以能實現「高頻寬」,關鍵在於擺脫了傳統平面通道的束縛。透過 3D 垂直疊加晶片,並輔以微米級的 TSV 穿孔技術,訊號得以在立體架構中進行垂直高速互連。這大幅縮短了物理傳輸路徑並倍增了資料通道數,有效克服 NAND Flash 原本存取速度較慢的先天限制。
- 精準定位 AI 系統的儲存缺口: 在現有的硬體配置中,HBM 造價高昂且容量受限,而遠端走傳統通道的 SSD 則面臨延遲過高的問題。HBF 憑藉「近端大容量儲存」的優勢,精準填補了兩者之間的架構空白,減少了運算核心對外部周邊設備的依賴。
市場時程與產業影響
根據目前的發展藍圖,HBF 預計將於 2027 年開始進入放量階段,並瞄準 2030 年成為 AI 伺服器的標準配置。如同 SK 海力士開發總監安炫所指出,當今 AI 基礎設施的競爭已非單一硬體指標的較量,而是整體生態系的優化能力。HBF 的導入,將成為帶動 AI 資料中心實現系統級降本增效的關鍵拼圖。
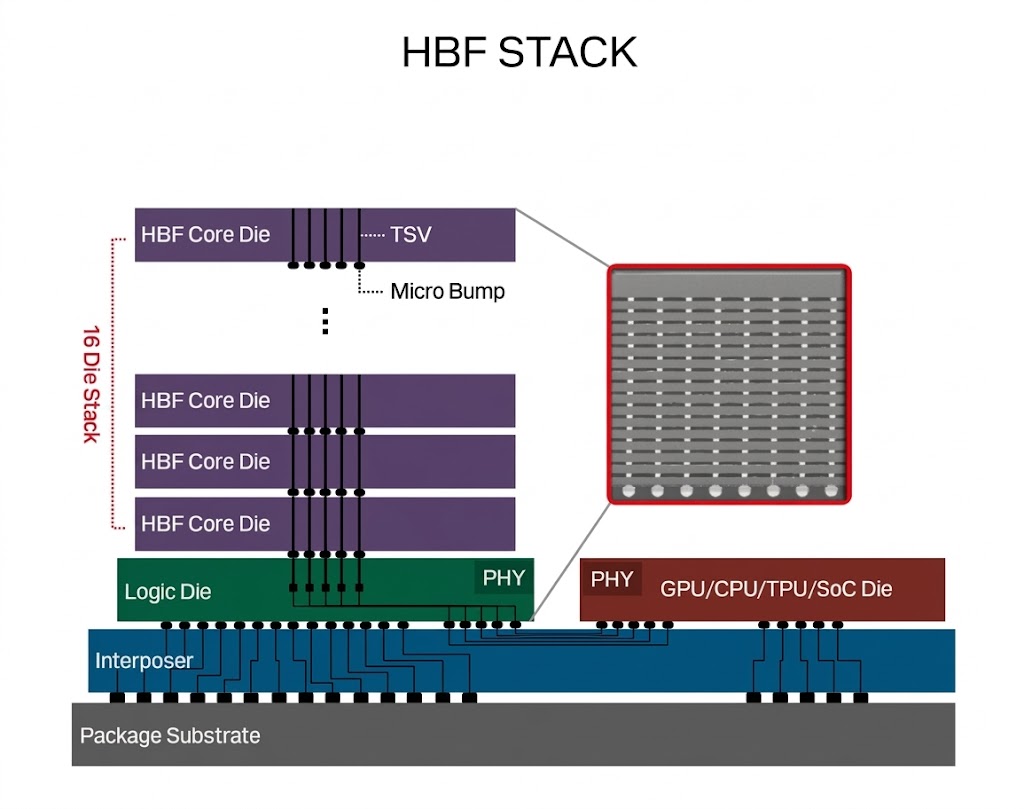 資料來源:SanDisk
AI 記憶體雙引擎:HBM 與 HBF 核心規格解析
為了更好了解這兩項 AI 基礎建設中重要的技術,股感從「系統架構」與「效能表現」等多重視角,進一步梳理 HBM 與 HBF 的核心差異與互補特性:
| 評估維度 | HBM (高頻寬記憶體) | HBF (高頻寬快閃記憶體) |
| 技術底層 | 基於 DRAM 架構 | 基於 SLC NAND Flash |
| 系統定位 | 擔綱 AI 運算主記憶體 | 擔任 AI 儲存層(介於 HBM 與 SSD 之間) |
| 傳輸與延遲 | 存取速度快、延遲極低 | 存取相對較慢、延遲較高 |
| 容量優勢 | 容量較小 | 具備大容量特性 |
| 產業進程 | 技術已達量產階段 | 規格標準尚在制定中 |
| 資料來源:自行整理 | ||
| HBM v.s. HBF 核心規格表 | ||
從上述的體質差異可以發現,兩者在伺服器生態系中並非零和競爭,而是為了解決截然不同的硬體痛點。在建置成本方面,DRAM 的單位儲存造價大約是 NAND Flash 的 50 倍,如此懸殊的價差,確實是驅動雲端大廠與系統整合商積極擁抱 HBF 的龐大商業誘因。
然而,這場硬體演進的背後並不僅僅是為了壓縮預算。Counterpoint Research 記憶體分析師 Jason Park 強調,HBF 的核心驅動力並非單純只為「降本」,更深層的戰略價值在於從架構層面實質打破 AI 系統在龐大資料吞吐下的傳輸瓶頸。
進一步剖析它們在實戰中的協同運作,這兩種技術共同勾勒出了未來 AI 伺服器的高效能藍圖。HBM 憑藉極低的延遲與超高頻寬,能緊貼運算核心,專注處理最吃重、最即時的動態運算,確保 GPU 算力不留白;而 HBF 則發揮其 TB 級大容量的先天優勢,在貼近運算單元的外圍築起一座近端水庫,負責囤積龐大的靜態模型權重。當算力全開時,HBF 能將海量資料穩妥且快速地批次輸送給前線的 HBM,讓硬體架構徹底擺脫過去「要容量還是要速度」的妥協,真正實現運算與儲存能力的完美平衡。
科技巨頭的戰略佈局:產業大事件與專家觀點
過去,HBF 多被視為個別記憶體廠商在實驗室中的前沿探索。然而,隨著全球 HBM 領航者 SK 海力士(SK Hynix)與 NAND Flash 巨頭閃迪(SanDisk / Western Digital)正式聯手,並在國際大會上記者會上公開發表全球首個 HBF 標準規格提案,象徵著這項技術正式邁入產業標準化的關鍵里程碑。
兩大巨頭的結盟不僅止於技術成果展示,其核心戰略在於透過統一規格,邀請雲端服務業者(CSP)、伺服器系統商與晶片設計商共同建構開放生態系。此舉一舉打破了過去記憶體規格各自為政的局面,大幅降低了後續系統整合與硬體開發的門檻,讓 HBF 正式從概念雛形走向可商業化落地的規格標準。
隨著首個標準規格問世,業界對於 HBF 未來的技術定位與市場走向,也碰撞出三種代表性的戰略視角:
- 激進取代觀點: 韓國科學技術院(KAIST)電機工程系教授金正鎬指出,憑藉顯著的容量擴充彈性與成本優勢,HBF 有機會在 10 年內逐漸取代部分 HBM 的市場份額。
- 互補融合觀點: 群聯電子執行長潘健成傾向「並存組合制」,SanDisk 亦主張「混合式架構」設計;Counterpoint Research 記憶體分析師 Jason Park 亦將 HBF 定位為 HBM 的「補充技術」,認為兩者將針對不同的資料讀寫負載進行專業化分工。
- 生態為王觀點: 產業專家敖國鋒直指商業落地的關鍵,強調不論技術指標多麼優異,哪一家記憶體廠商能率先取得與 Nvidia、AMD 等 AI 加速晶片龍頭的深度合作,才具備將該技術推向市場主流的決定性力量。
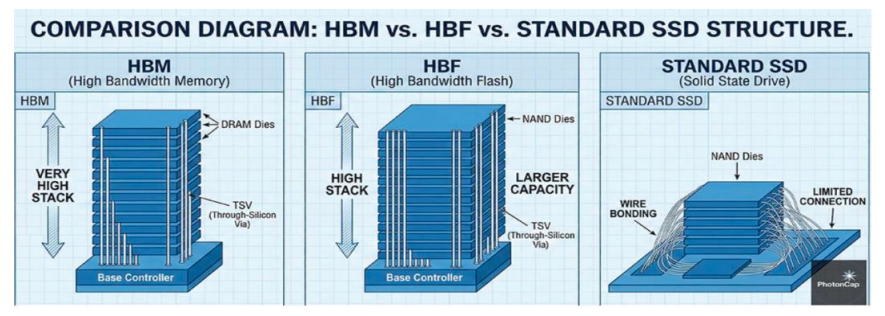 資料來源:華南期貨
從 SK 海力士與閃迪大動作建立標準規格,到各大專家對技術路徑的討論可以發現,HBF 的誕生代表著 AI 基礎設施的競爭重心已從單一元件的性能極限,轉向「系統級生態系的優化能力」。這場由記憶體龍頭發起的標準化運動,不僅驗證了近端大容量儲存的商業可行性,也為 AI 伺服器架構的變革確立了明確的推進方向。
HBF 何時商業化:從訓練邁向推論
隨著 AI 產業從動用巨額資金的「模型訓練」,加速走向講求商業效益與大規模應用的「AI 推論」,記憶體架構的變革已成必然。結合產業鏈的最新佈局,HBF 的崛起將沿著以下三大脈絡展開:
需求端的轉折:AI 推論成為 HBF 展現價值的最佳戰場
在模型訓練階段,系統需要極高頻率的資料重複讀寫,極速的 HBM 依然不可或缺;然而,當 AI 進入商業化的推論階段,運算任務轉變為「頻繁讀取已定型的模型,但極少覆寫」。採用 SLC 架構的 HBF,剛好能完美發揮其高耐用度與大容量的優勢,以極高的性價比來承載這些海量的靜態模型資料。
架構端的突破:多層協同打造高性價比的 TB 級儲存
未來的 AI 伺服器將不再依賴單一記憶體,而是走向更精細的分工:由 HBM 專責極速運算,HBF 在近端提供 TB 級的大容量儲存池,傳統 SSD 則負責遠端備份。HBF 傳承了快閃記憶體成本親民、儲存密度高的優勢,能以遠低於 DRAM 的建置成本提供高頻寬傳輸,幫助企業大幅降低資料中心的建置與電力維運成本(TCO)。
落地端的推升:2026 規格確立,2027 迎來商業放量
- 2026 年(規格標準化): 由 SK 海力士與閃迪(SanDisk)主導,並獲得國際雲端大廠與晶片設計商響應,向 OCP(開放運算計畫)提交全球首個 HBF 標準規範,奠定開放生態系的基礎。
 資料來源:SanDisk
- 2027 年(伺服器導入放量): 隨著技術樣品測試完成,HBF 預計正式進入商業化量產,率先導入新一代 AI 推論伺服器。
- 2030 年(資料中心主流標配): 隨著技術普及與供應鏈成熟,HBF 預計成為全球各大 AI 資料中心的標準配置。
梳理整體時間軸與產業脈絡可以發現,HBF 的誕生並非要零和取代 HBM,而是宣告 AI 基礎設施的競爭已從「單純堆疊晶片算力」,邁入「追求系統整體性價比與商業落地」的新階段。從 2026 年的規格確立到 2027 年的商業放量,HBM 與 HBF 的雙引擎協同,將成為龐大 AI 模型得以顯著降低門檻、真正實現大規模商用普及的核心推手。
HBF 概念股有哪些?
將上述關鍵廠商依據「產業鏈角色」進行分類,能更清晰地看出各家業者在 AI 記憶體變革中的戰略位置:
一、 記憶體製造原廠(IDM)
- SK 海力士(SK Hynix): HBM 市場領頭羊,同時也是 HBF 技術規格制定的核心發起者,兼具極速運算與近端大容量儲存優勢。
- 威騰電子(Western Digital / SanDisk): NAND Flash 巨頭,與 SK 海力士深度合作推動 HBF 標準化,主導快閃記憶體在 AI 儲存層的落地。
- 三星電子(Samsung): 全球記憶體龍頭,積極擴充 HBM 產能,並同步佈局 CXL 與新世代快閃記憶體技術。
- 美光(Micron): 美系記憶體指標大廠,高頻寬記憶體主力供應商之一,持續推進高傳輸速度的 AI 記憶體方案。
二、 晶圓代工與先進封裝
- 台積電(TSMC): 全球晶圓代工與封裝霸主。無論是 HBM 還是 HBF,將多層記憶體透過矽穿孔與 GPU 垂直整合,皆高度仰賴其 CoWoS 與 3D 先進封裝產能。
三、 控制晶片與高速傳輸
- 群聯(Phison): 台灣快閃記憶體控制晶片龍頭。HBF 採用 SLC 顆粒並要求高頻寬吞吐,需要其強大的主控晶片來處理資料調度與高速介面傳輸。
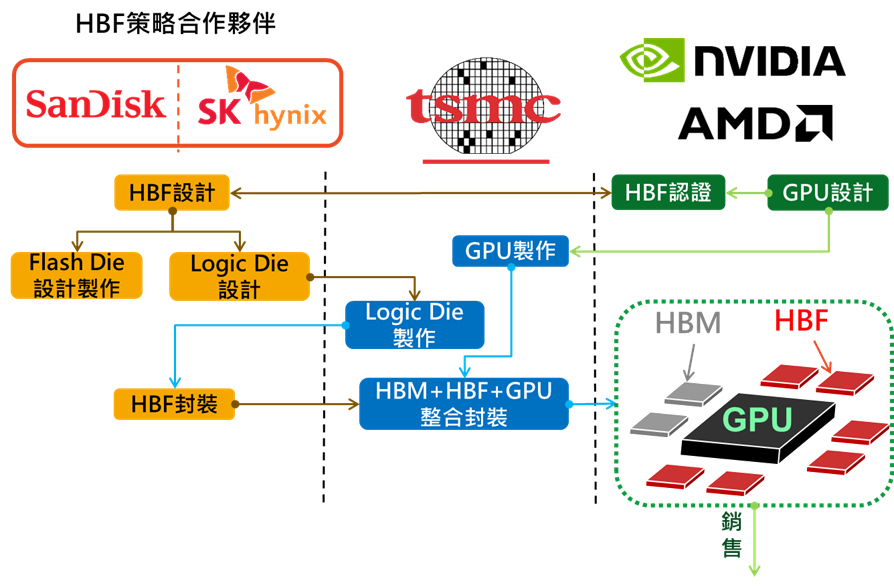 資料來源:資策會產業情報研究所 (MIC)
總結
總結而言,隨著 AI 產業的核心演進從巨額投資的「模型訓練」轉向講求效益與商業落地的「AI 推論」,基礎設施的瓶頸已不再單純是算力大小,而是資料傳輸的整體效率與建置成本。HBF 的誕生,並非要零和取代 HBM,而是與 HBM 形成強大的雙引擎協同——由 HBM 專責極速運算,HBF 在近端提供 TB 級的大容量模型儲存池。從 2026 年開放規格確立到 2027 年正式商業放量,HBM 與 HBF 的多層級協作,將成為千億甚至兆級參數大模型大幅降低商用門檻、實現普及落地的核心支柱。
【延伸閱讀】
- 記憶體分成哪幾類?記憶體產業趨勢分析!記憶體概念股可以投資嗎?
- 美光 MU FY26Q4 財報:單季營收 542 億年增 379%,DRAM 全年突破千億!
- HDD 是什麼?別再只看 HBM、SSD!HAMR是什麼?概念股有哪些?
- 記憶體股為什麼暴跌?Google TurboQuant 是什麼?記憶體還能買嗎?
